Görüntü Bölütleme Teknolojileri ve Kümeleme Matematiği (Image Segmentation Foundations)
- 1. Genel Bakış ve Bölütleme Stratejileri (Overview)
- 2. İnsan Görsel Sisteminde Bölütleme (Segmentation by Humans)
- 3. Kümeleme Olarak Bölütleme Matematiği (Segmentation as Clustering)
- 4. k-Means Bölütleme (k-Means Segmentation)
- 5. Mean-Shift Bölütleme (Mean-Shift Segmentation)
- 6. Grafik Tabanlı Bölütleme (Graph-Based Segmentation)
- 7. Özetleyici Teknik Karşılaştırma Matrisi
Bu ders notu, bilgisayarlı görünün en temel ve “tanımsız/belirsiz” (ill-defined) problemlerinden biri olan Görüntü Bölütleme (Image Segmentation) konusunu; insan fizyolojisi ve Gestalt algı kurallarından başlayarak, piksel özellik uzayında kümeleme matematiğini, k-Means ve Mean-Shift algoritmalarını ve modern spektral grafik teorisine dayanan Normalized Cuts (NCut) yaklaşımlarını tüm akademik, matematiksel ve algoritmik detaylarıyla Columbia Üniversitesi CAVE laboratuvarı (Prof. Shree K. Nayar) müfredatı doğrultusunda ele almaktadır.
1. Genel Bakış ve Bölütleme Stratejileri (Overview)
Görüntü Bölütleme (Image Segmentation); bir dijital görüntüyü kendi içinde görsel, geometrik veya anlamsal (semantik) olarak homojen, tutarlı ve anlamlı alt bölgelere (segmentlere) ayrıştırma sürecidir. Bölütleme; nesne tespiti (object detection), nesne tanıma (object recognition), 3B sahne anlama ve görüntü sınıflandırma (classification) gibi üst düzey bilgisayarlı görü problemleri için kritik bir ön hazırlık (precursor) adımıdır.
1.1 İlkel Bölütleme Yaklaşımları
Genel bölütleme teorisine geçmeden önce, bilgisayarlı görü literatüründe geçmişte sıkça başvurulan iki ilkel yaklaşım şunlardır:
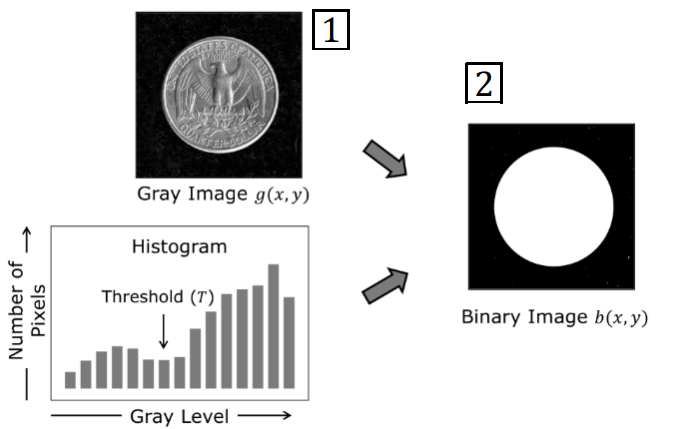
- Histogram Eşikleme (Thresholding): Nesnenin homojen ve tek renkli bir arka plan üzerinde durduğu basit senaryolarda görüntünün parlaklık histogramı çıkarılır. Histogramdaki iki ana tepe noktası arasındaki vadi saptanarak uygun bir $T$ eşiği belirlenir ve görüntünün pikselleri $I(x,y) > T$ kuralına göre siyah-beyaza (binary) indirgenerek bölütlenir.
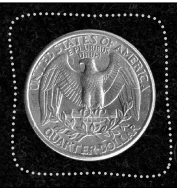
- Aktif Konturlar (Active Contours / Snakes): Görüntü üzerine kullanıcı tarafından yaklaşık dairesel bir başlangıç konturu yerleştirilir. Bu elastik kontur, içsel gerilim/bükülme kuvvetleri ve dışsal görüntü kuvvetleri (gradyanlar) altında otomatik olarak büzülüp genişleyerek nesnenin kesin sınır çizgisine kilitlenir (latch). Ancak bu yöntem kullanıcı müdahalesi ve manuel başlatma (initialization) gerektirdiğinden genel ve tam otomatik bölütleme problemini çözemez.
1.2 Bölütlemenin “Tanımsız” (Ill-Defined) ve Öznel Doğası
Doğal sahneler (natural scenes) üzerinde genel bir bölütleme yapmaya çalıştığımızda, karşımıza “anlamlı bölüt” (meaningful segment) kavramının mutlak bir matematiksel tanımının olmaması problemi çıkar.
- Örnek Senaryo: Şapka takmış bir insanın fotoğrafında şapka insanın bir parçası olarak tek bir segment mi sayılmalıdır, yoksa bağımsız iki ayrı segment mi? Bu sorunun cevabı tamamen çözülmek istenen göreve, bağlama ve uygulamaya bağlıdır.
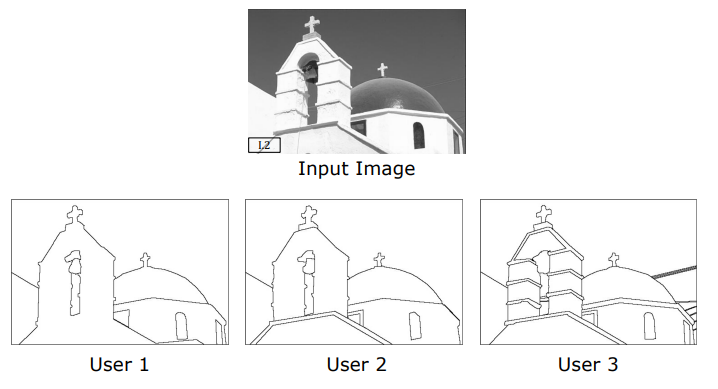
- İnsan Öznelliği: Martin ve arkadaşları (2001) tarafından yapılan psikofiziksel deneylerde, aynı doğal manzara fotoğrafları farklı insan deneklere verilmiş ve onlardan anlamlı bölütler çizmeleri istenmiştir. Deney sonuçlarında, bir kişinin görüntüyü sadece kaba dış hatlarıyla ayırdığı, bir diğerinin mimari süslemelere kadar indiği, üçüncü bir kişinin ise mikro dekoratif parçaları dahi ayrı birer segment olarak kaydettiği görülmüştür. Bölütleme, insanlar için bile son derece öznel (subjective) bir süreçtir.
1.3 İki Temel Bölütleme Paradigması
Bu karmaşıklığı yönetmek ve algoritmik bir çerçeveye oturtmak için iki temel strateji geliştirilmiştir:
flowchart TD
    Input["Doğal Görüntü Girişi (Input Image)"] --> Split{"Bölütleme Paradigması"}
    Split --> BU["Aşağıdan Yukarıya (Bottom-Up)\n• Görsel öznitelik benzerliği (renk, doku, konum)\n• Özellik uzayında kümeleme (Clustering)\n• Önsel nesne bilgisi gerektirmez"]
    Split --> TD["Yukarıdan Aşağıya (Top-Down)\n• Global nesne modelleri ve Gestalt şablonları\n• Önce nesne tespiti, ardından parçalama\n• Önsel bilgi ve tanıma modelleri gerektirir"]
    style Input fill:#1a1a2e,stroke:#e94560,color:#fff
    style Split fill:#16213e,stroke:#4cc9f0,color:#fff
    style BU fill:#0f3460,stroke:#4cc9f0,color:#fff
    style TD fill:#0f3460,stroke:#e94560,color:#fff
- Yukarıdan Aşağıya (Top-Down) Bölütleme: Piksellerin bir araya gelme sebebi, onların aynı global nesneye (object model) ait olmalarıdır. Sistem önce nesneyi tespit eder, ardından alt parçalarını bölütler.
- Aşağıdan Yukarıya (Bottom-Up) Bölütleme: Piksellerin bir araya gelme sebebi, onların yerel ve görsel özniteliklerinin (renk, parlaklık, doku, konum vb.) benzer olmasıdır. Matematiksel olarak modellenmesi çok daha elverişli olan bu yaklaşım, bölütleme problemini saf bir Özellik Uzayında Kümeleme (Clustering) problemi haline indirger.
2. İnsan Görsel Sisteminde Bölütleme (Segmentation by Humans)
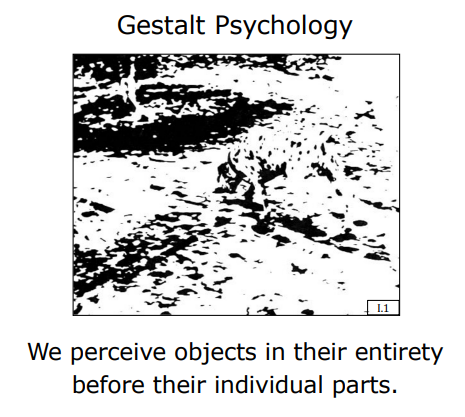
İnsanların karmaşık sahnelerdeki nesneleri milisaniyeler içinde nasıl gruplayıp bölütlediğini açıklayan en güçlü psikolojik çerçeve Gestalt Psikolojisidir (Almanca “biçim/bütünlük”). Bu teorinin temel direği, görsel sistemimizin nesneleri parçalarından bağımsız olarak önce bütünüyle (entirety) bir grup olarak algıladığı, ardından o grubun alt elemanlarını (subgroups) saptadığı gerçeğidir.
Dalmaçyalı Köpek Olgusu: Siyah-beyaz lekelerden oluşan soyut bir resme baktığımızda, bir süre sonra gözümüz resmin ortasındaki Dalmaçyalı köpeği bir bütün olarak saptar. Bu bütünü algıladıktan sonra köpeğin ayaklarını, kafasını ve kuyruğunu (alt grupları) ayırt edebiliriz.
Todorovic (2008) ve Smith (1988), insan beyninin pikselleri ve görsel uyarıcıları bir araya getirmek (grouping) için kullandığı temel Gestalt kurallarını şu şekilde tanımlamıştır:
2.1 Yakınlık İlkesi (Proximity)
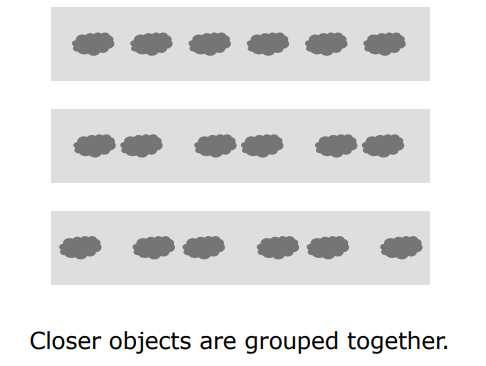
Uzamsal olarak birbirine daha yakın konumlandırılmış olan nesneler ve ögeler, görsel sistemimiz tarafından otomatik olarak bir grup/alt grup olarak algılanır. Eşit aralıklı noktalar tek bir bütün oluştururken, noktalar arasındaki bağıl mesafeler değiştirildiğinde anında ikişerli veya üçerli alt kümeler belirir.
2.2 Benzerlik İlkesi (Similarity)
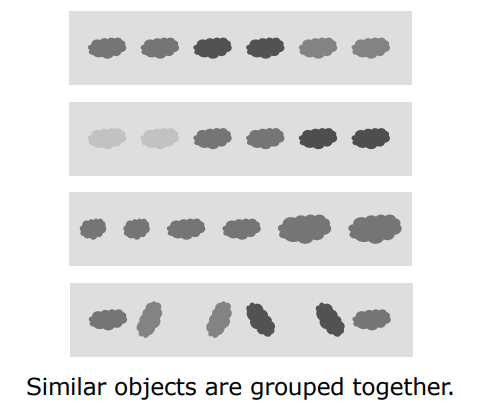
Görünüm özellikleri (parlaklık, renk, boyut, yönelim vb.) benzer olan görsel elemanlar bir arada gruplanır.
- Rekabet Durumu: Benzerlik ile yakınlık ilkeleri birbiriyle rekabet ettiğinde (örneğin farklı renklerdeki noktalar birbirine çok yakın çiftler halinde dizildiğinde), genellikle yakınlık ilkesi baskın gelir ve farklı renkte olsalar dahi birbirine yakın duran çiftleri tek bir alt grup olarak algılarız.
2.3 Ortak Kader İlkesi (Common Fate)
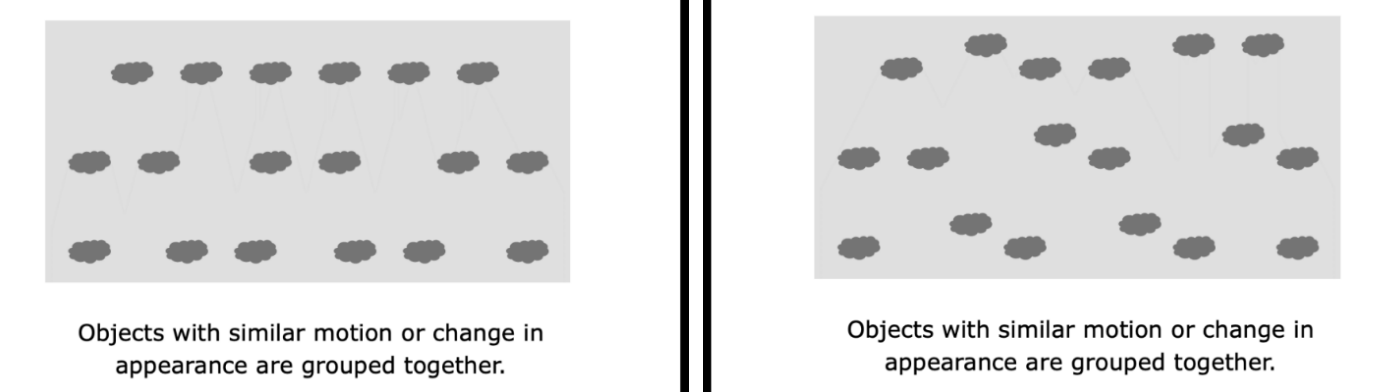
Birbirinden uzamsal olarak çok uzakta veya dağınık olsalar dahi, aynı doğrultuda ve aynı hızla hareket eden (aynı “kadere” sahip olan) veya görünümünü senkronize değiştiren tüm görsel elemanlar beyin tarafından anında bağımsız tek bir grup olarak birleştirilir.
2.4 Ortak Bölge ve Bağlantılılık (Common Region & Connectivity)
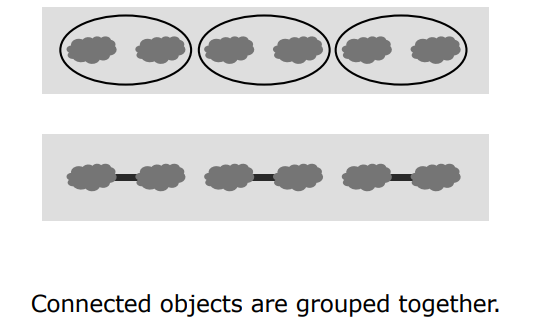
Üzerlerine kapalı sınırlar (elipsler/kutular) çizilmiş veya ince çizgisel linklerle birbirine fiziksel olarak bağlanmış görsel elemanlar, uzamsal aralıkları tamamen üniform olsa dahi bağlantılılık kuralı gereğince anında bağımsız alt gruplar olarak algılanır.
2.5 Süreklilik İlkesi (Continuity)
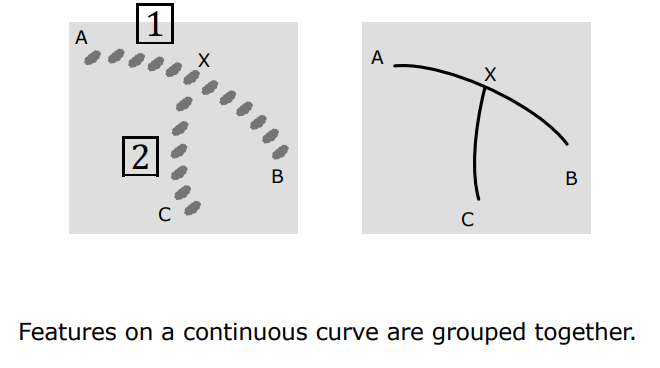
Aynı pürüzsüz ve sürekli bir geometrik eğri (continuous curve) üzerine hizalanmış olan görsel noktalar ve parçacıklar, aralarında fiziksel boşluklar olsa veya kesişmeler bulunsa dahi görsel sistemimiz tarafından tek bir hat olarak algılanır.
2.6 Simetri İlkesi (Symmetry)
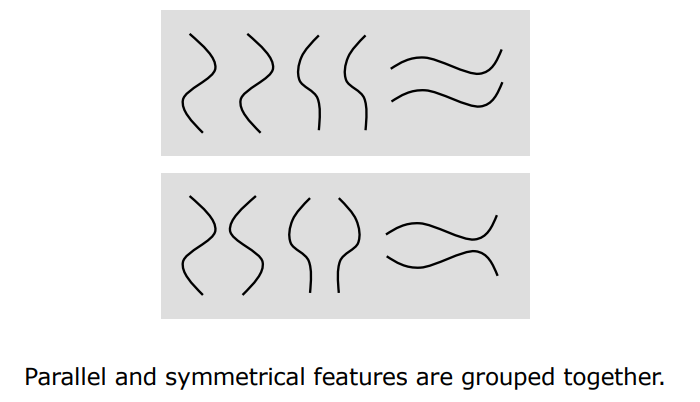
Birbirine paralel ve simetrik (öteleme veya yansıma simetrisi) olan yapılar çok güçlü bir gruplama uyarısı oluşturur. Fiziksel dünyada iki tamamen bağımsız nesnenin şans eseri kusursuz bir simetri oluşturma olasılığı neredeyse sıfırdır; dolayısıyla simetrik yapılar beyin tarafından kesinlikle aynı gruba ait kabul edilir.
3. Kümeleme Olarak Bölütleme Matematiği (Segmentation as Clustering)
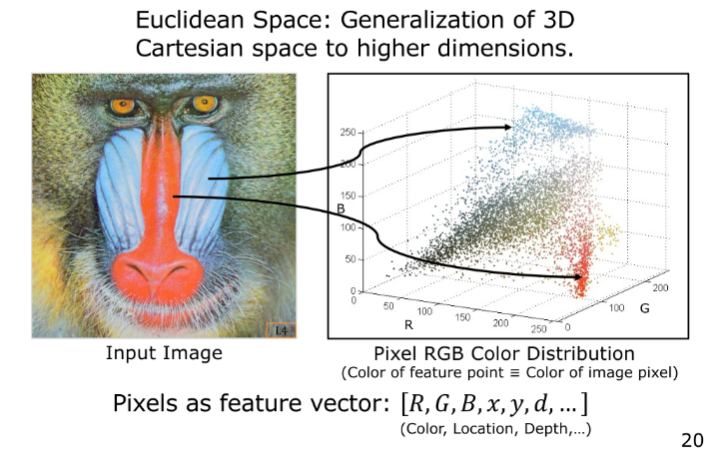
Aşağıdan yukarıya (bottom-up) bölütleme felsefesinde, görüntüdeki her bir pikseli temsil etmek üzere ölçülebilen veya hesaplanabilen görsel özelliklerden oluşan yüksek boyutlu bir Özellik Vektörü (Feature Vector - $\mathbf{f}_i$) tanımlanır.
3.1 Piksel Özellik Uzayı (Feature Space)
Piksel özellik vektörünü oluşturmak için şu bileşenler bir araya getirilebilir:
- Ölçülebilen Özellikler: Pikselin parlaklığı ($I$), renk kanalları ($R, G, B$).
- Uzamsal Koordinatlar: Pikselin görüntü düzlemindeki konumu ($x, y$).
- Hesaplanabilen Özellikler: Aktif aydınlatma (ToF), defocus veya stereo ile saptanan derinlik ($z$ / $d$); piksellerin zamansal hareketini belirten optik akış vektörleri ($u, v$); yerel doku (texture) tanımlayıcıları ve malzeme yansıtma (BRDF) özellikleri.
$$\mathbf{f}_i = \begin{bmatrix} R \ G \ B \ x \ y \ d \ \vdots \end{bmatrix}$$
Bu özellik vektörü, her pikseli yüksek boyutlu bir Öklid Uzayına (Euclidean Space - $n$-space) birer nokta olarak haritalar.
3.2 Piksel Benzerliği ve Öklid Mesafesi
İki piksel ($i$ ve $j$) arasındaki görsel benzerliği ölçmek için, bu piksellerin özellik uzayındaki haritaları ($\mathbf{f}_i$ ve $\mathbf{f}_j$) arasındaki $\mathcal{L}_2$ (Öklid) uzaklığı hesaplanır:
$$\mathcal{L}_2(\mathbf{f}_i, \mathbf{f}_j) = |\mathbf{f}_i - \mathbf{f}_j| = \sqrt{\sum_{k=1}^D (f_{ik} - f_{jk})^2}$$
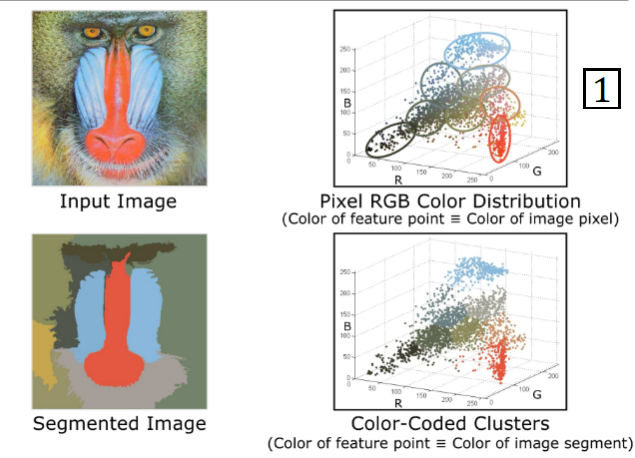
Bu matematiksel kurala göre; özellik uzayındaki mesafe ne kadar küçükse, iki piksel arasındaki görsel ve geometrik benzerlik o kadar büyüktür. Görüntü bölütleme, benzer pikselleri özellik uzayında bir araya getiren kümeleme (clustering) algoritmalarının çalıştırılmasına indirgenir.
4. k-Means Bölütleme (k-Means Segmentation)
k-Means, bilgisayarlı görüde en sık kullanılan, uygulaması kolay ve hızlı bir bölütleme algoritmasıdır. Lloyd-MacQueen algoritmasına dayanır.
4.1 Algoritmanın Çalışma Adımları
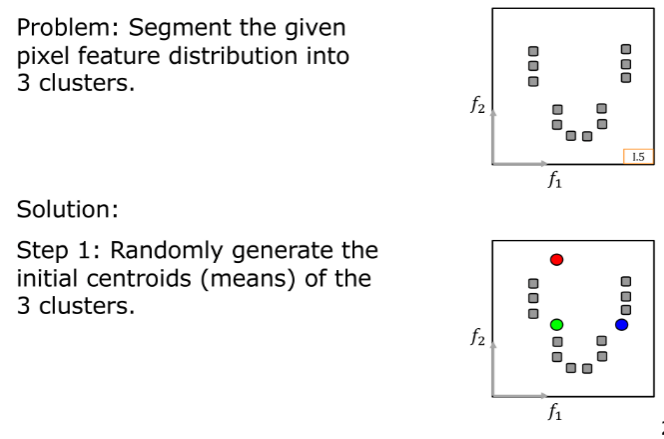
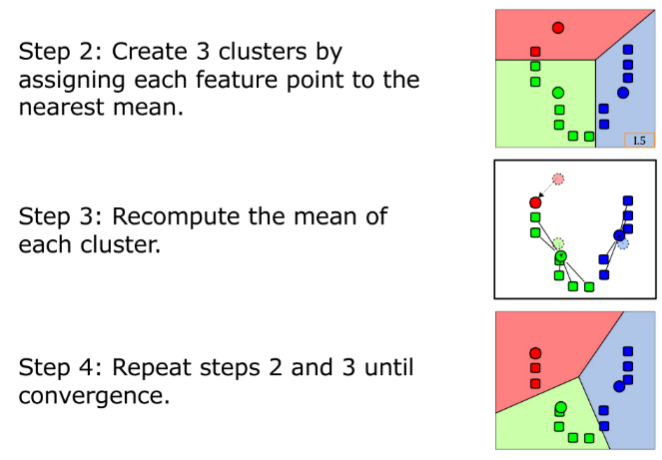
Verilen bir $N$ pikselli görüntüden $k$ adet segment (küme) elde etmek için şu adımlar izlenir:
flowchart TD
    Init["Adım 1: İlklendirme\nÖzellik uzayından rastgele k adet merkez seç: {m_1, m_2, ..., m_k}"] --> Assign["Adım 2: Piksel Atama\nHer pikseli kendine en yakın merkeze ata:\nCluster(x_j) = argmin_i ||f_j - m_i||"]
    Assign --> Update["Adım 3: Merkez Güncelleme\nKümelerdeki piksellerin aritmetik ortalamasını al:\nm_i = (1 / N_i) ∑ f_j"]
    Update --> Check{"Adım 4: Yakınsama Kontrolü\n||Δm_i|| < ε ?"}
    Check -- "Hayır" --> Assign
    Check -- "Evet" --> Done["Bölütleme Tamamlandı\nHer kümeye benzersiz renk/etiket atanır"]
    style Init fill:#1a1a2e,stroke:#e94560,color:#fff
    style Assign fill:#16213e,stroke:#4cc9f0,color:#fff
    style Update fill:#0f3460,stroke:#4cc9f0,color:#fff
    style Check fill:#1b262c,stroke:#f9bc60,color:#fff
    style Done fill:#0f4c5c,stroke:#00b4d8,color:#fff
- İlklendirme (Initialization): Özellik uzayında $k$ adet başlangıç merkezi seçilir: ${m_1, m_2, \dots, m_k}$.
- Piksel Atama (Assignment): Her bir $x_j$ pikseli için en yakın $m_i$ merkezi saptanır ve piksel $i$. kümeye atanır: $$\text{Atama}(x_j) = \arg\min_{i} |\mathbf{f}_j - m_i|$$
- Merkez Güncelleme (Update): Her bir kümenin yeni merkezi, o kümeye atanan tüm piksellerin aritmetik ortalaması alınarak yeniden hesaplanır: $$m_i = \frac{1}{N_i} \sum_{j \in \text{Cluster } i} \mathbf{f}_j$$
- Yakınsama Kontrolü (Convergence): Eğer tüm $k$ merkezdeki kayma miktarı belirlenen çok küçük bir $\epsilon$ eşik değerinden küçükse algoritma yakınsamış kabul edilerek durdurulur; aksi takdirde Adım 2’ye geri dönülür.
4.2 Merkez İlklendirme Yöntemleri (Initialization Methods)
k-Means yerel minimumlara (local minima) karşı hassas olduğundan, başlangıç merkezlerinin doğru seçilmesi hayati önem taşır:
- Yöntem 1 (Rastgele Seçim): Dağılımdan tamamen rastgele $k$ nokta seçilir. Seçilen iki nokta birbirine çok yakınsa, dengeli kümelenme için süreç tekrarlanarak yeniden örnekleme (resample) yapılır.
- Yöntem 2 (Üniform Dağıtım): Özellik uzayındaki tüm dağılımın sınır kutusu (bounding box) hesaplanır ve $k$ adet merkez bu kutunun içine sınırlar dahilinde eşit aralıklarla (uniform) dağıtılır.
- Yöntem 3 (Alt Küme k-Means - En Kararlı Yaklaşım): Görüntüdeki milyonlarca piksel arasından rastgele çok küçük bir alt küme (örneğin 100 veya 1000 piksel) seçilir. Bu küçük grup üzerinde k-Means çalıştırılır ve elde edilen kararlı merkezler, tüm görüntünün k-Means işleminde başlangıç merkezleri olarak atanır.
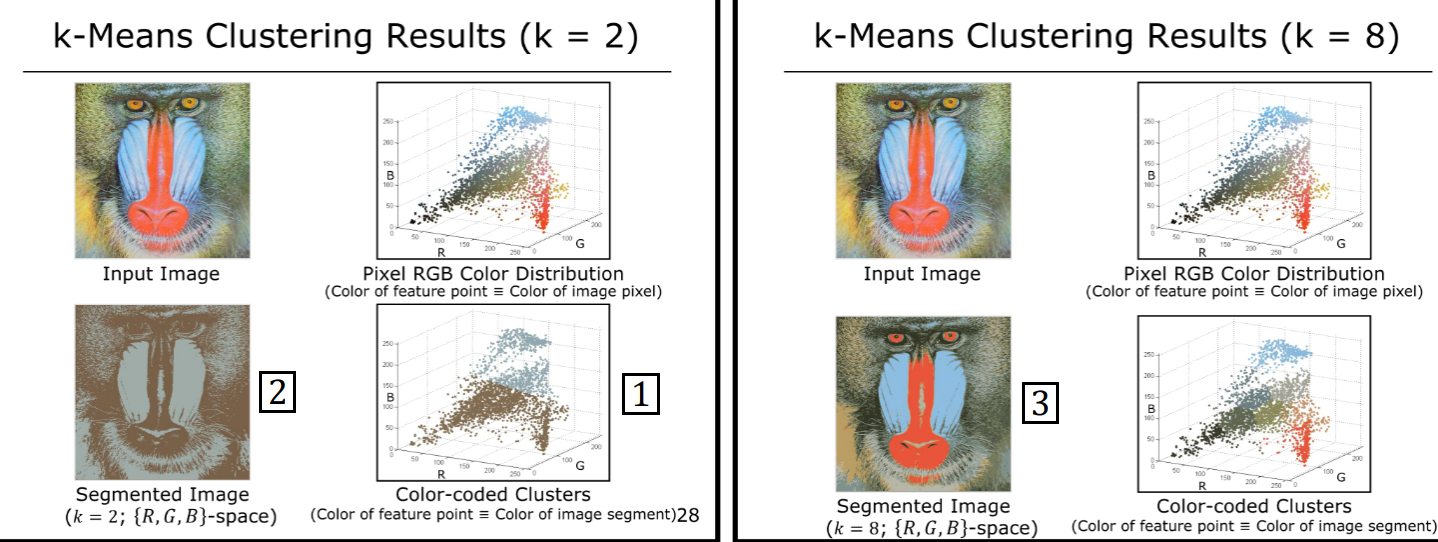
4.3 Küme Sayısı $k$’nın Etkisi
Küme sayısı $k$, bölütlemenin detay seviyesini doğrudan belirler:
4.4 Boyut Problemi: RGB vs. RGB-XY Uzayı
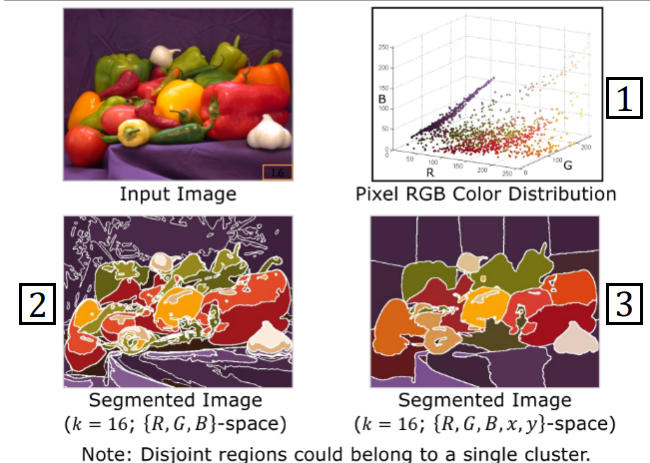
- Sadece Renk Uzayı Kullanımı (RGB): Görüntüyü sadece RGB renk uzayında kümelediğimizde, görüntünün tamamen farklı yerlerinde bulunan ama renkleri aynı olan bağımsız nesne parçaları aynı kümede birleşir (disjoint regions). Örneğin, yeşil biber görüntüsünde sol üstteki yaprak ile sağ alttaki biber parçası aynı küme etiketini alır.
- Konumsal Koordinatların Entegrasyonu (RGB-XY): Bu sorunu çözmek için piksel özellik vektörüne uzamsal $(x,y)$ koordinatları da dahil edilerek 5 boyutlu bir özellik uzayı ($\mathbf{f} = [R, G, B, x, y]^T$) oluşturulur. Bu sayede, birbirine yakın olan benzer renkli piksellerin aynı bölgeye ait olması teşvik edilirken, uzaktaki piksellerin ayrılması sağlanır.
k-Means’in Temel Zayıflıkları:
- Küme sayısı $k$ kullanıcı tarafından önceden kesin olarak verilmelidir.
- Başlangıç merkezlerine aşırı derecede duyarlıdır (farklı ilklendirmeler çok farklı sonuçlar üretir).
- Aykırı değerlere (outliers) karşı dayanıksızdır; tek bir gürültü pikseli tüm küme merkezini kendine çekebilir.
5. Mean-Shift Bölütleme (Mean-Shift Segmentation)
Mean-Shift, k-Means algoritmasının iki büyük dezavantajını (önceden $k$ belirtme zorunluluğu ve ilklendirme hassasiyeti) tamamen ortadan kaldıran parametresiz, olasılıksal bir tepe tırmanma (hill-climbing / gradient ascent) yöntemidir (Comaniciu & Meer, 2002).
5.1 Olasılık Yoğunluk Tepeleri ve Mod (Mode) Konsepti
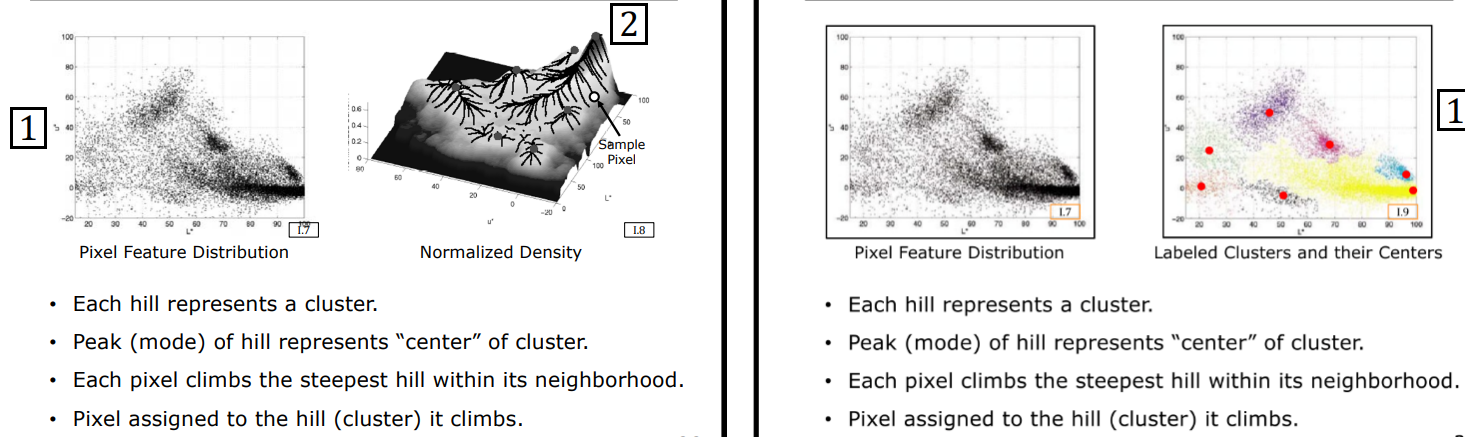
Özellik uzayındaki piksellerin dağılımı, pürüzsüz bir Olasılık Yoğunluk Fonksiyonu (Probability Density Function - PDF) olarak modellenir. Bu fonksiyon, 3B uzayda inişli çıkışlı tepelerden (hills) ve vadilerden oluşan bir coğrafi haritaya benzer:
- Haritadaki her bir tepe (hill), bağımsız bir kümeyi (segmenti) temsil eder.
- Tepenin en yüksek zirve noktası (mode / peak), o kümenin geometrik merkezidir.
- Görüntüdeki her bir piksel, kendi yerel komşuluğundaki en dik eğimi takip ederek en yüksek tepeye doğru tırmanır (hill-climbing).
- Aynı zirveye (mode) ulaşan tüm pikseller, aynı bölüte (segment değerine) atanır. Bu sayede bölüt sayısı $k$ önceden belirtilmez; sistem tarafından doğal olarak keşfedilir.
5.2 Mean-Shift Algoritması Adımları
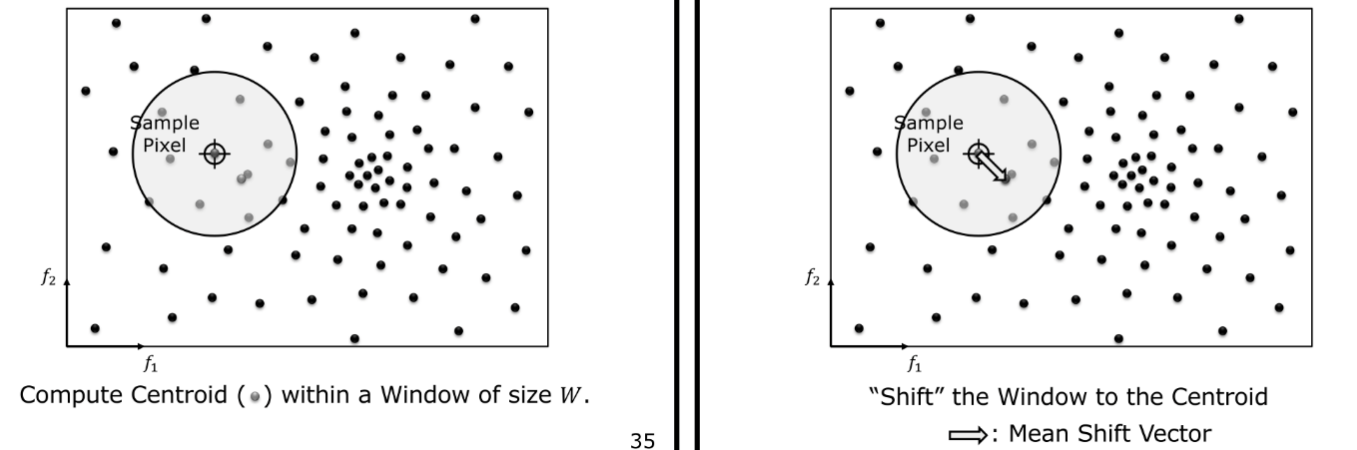
$N$ pikselli bir dağılım ve $W$ yarıçapında dairesel bir analiz penceresi (bandwidth / window size) verildiğinde süreç şu şekilde işler:
- Her bir $i$ pikselinin başlangıç konumu kendi özellik değerine eşitlenir: $m_i^{(0)} = \mathbf{f}_i$.
- $m_i$ merkezli, $W$ yarıçapına sahip dairesel/küresel bir pencere yerleştirilir.
- Pencerenin içinde kalan tüm noktaların ağırlıklı merkezi (centroid) hesaplanır: $$m = \frac{\sum_{\mathbf{x}_j \in W(m_i)} K(\mathbf{x}_j - m_i) \mathbf{x}_j}{\sum_{\mathbf{x}_j \in W(m_i)} K(\mathbf{x}_j - m_i)}$$
- Pencerenin merkezi, hesaplanan bu yeni ağırlıklı merkeze doğru kaydırılır ($m_i \leftarrow m$). Bu kayma vektörüne Mean Shift Vektörü denir.
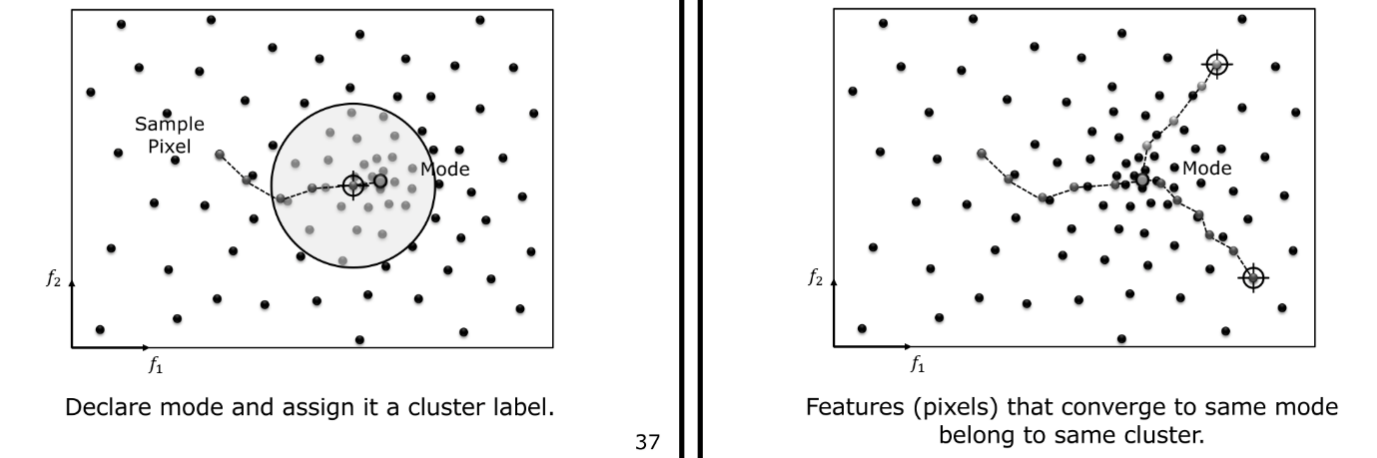
- Kayma miktarı belirlenen çok küçük bir $\epsilon$ değerinin altına inene kadar (pencere zirveye ulaşıp durana kadar) Adım 2 ve 4 tekrarlanır.
- Zirveye ulaşan nokta o pikselin modu (mode) kabul edilir. Aynı moda yakınsayan tüm pikseller aynı küme etiketiyle işaretlenir.
5.3 k-Means ve Mean-Shift Karşılaştırması
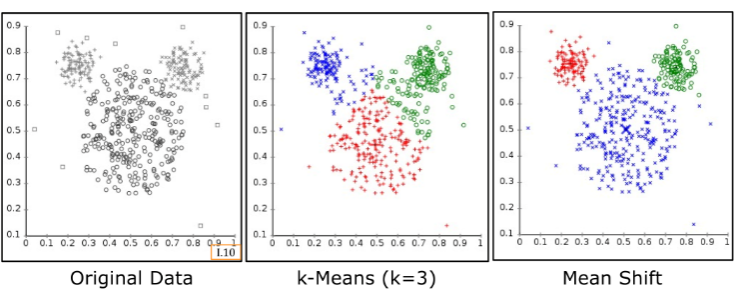
- Aykırı Değer (Outlier) ve Şekil Dayanıklılığı: k-Means, kümelerin küresel (dairesel) olduğunu varsayar ve dışta kalan aykırı değerlerden ötürü merkezleri kaydırarak hatalı bölütler üretir. Mean-Shift ise yerel yoğunluk tepelerine tırmandığından, karmaşık geometrileri (örneğin Mickey Mouse dağılımı gibi iç içe geçmiş veya farklı yoğunluklu kümeleri) ve aykırı değerleri kusursuz şekilde yönetir.
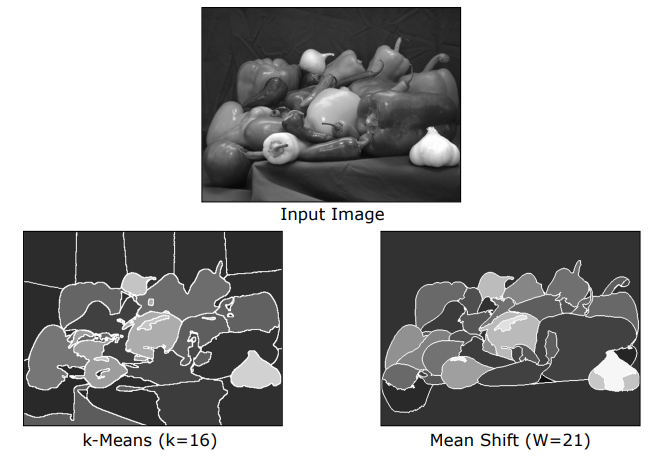
Mean-Shift Değerlendirmesi:
- Avantajları: $k$ parametresi gerektirmez, keyfi küme şekillerini bulabilir, aykırı değerlere karşı son derece dirençlidir.
- Dezavantajları: Hesaplama maliyeti çok yüksektir (her bir tekil piksel için tepe tırmanma döngüsü yürütülür). Sonuçlar seçilen pencere boyutu $W$ parametresine aşırı duyarlıdır ($W$ çok küçükse aşırı bölütleme, çok büyükse segmentlerin birleşmesi gerçekleşir).
6. Grafik Tabanlı Bölütleme (Graph-Based Segmentation)
Grafik tabanlı bölütleme, görüntüyü piksel bazlı bağımsız bir kümeleme problemi olarak görmek yerine, pikselleri birbirine bağlayan devasa bir ilişkisel ağ (graph) olarak modeller.
6.1 Görüntünün Grafik Olarak Temsili
Görüntü, $G = (V, E)$ şeklinde ağırlıklı ve yönsüz bir grafiğe dönüştürülür:
- Düğümler (Vertices - $V$): Görüntüdeki her bir piksel grafikte bir düğümdür.
- Kenarlar (Edges - $E$): Piksel çiftleri arasında tanımlanan bağlantılardır.
- Kenar Ağırlığı (Weight - $w(i,j)$): İki piksel arasındaki Affinity (Yakınlık / Benzerlik) değeridir.
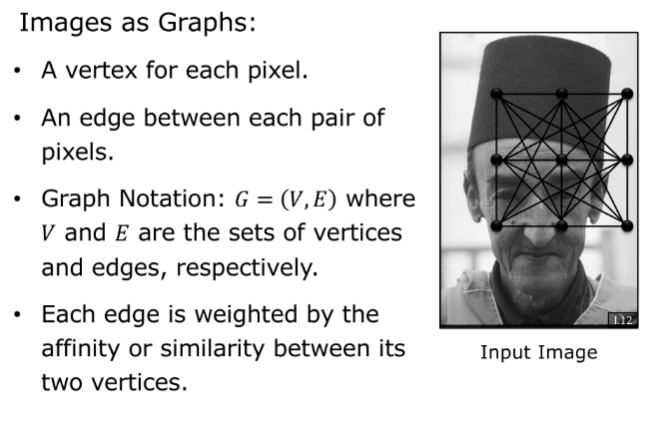
Piksel Yakınlığı (Affinity) Formülasyonu
$\mathbf{f}_i$ ve $\mathbf{f}_j$ özelliklerine sahip iki piksel arasındaki farklılık mesafesi $S(\mathbf{f}_i, \mathbf{f}_j) = |\mathbf{f}_i - \mathbf{f}_j|^2$ olsun. Aralarındaki afinite $w(i,j)$, negatif üslü bir Gauss fonksiyonu ile tanımlanır:
$$w(i,j) = A(\mathbf{f}_i, \mathbf{f}_j) = e^{-\frac{1}{2\sigma^2} |\mathbf{f}_i - \mathbf{f}_j|^2}$$
- İki piksel birbirine ne kadar çok benziyorsa ($|\mathbf{f}_i - \mathbf{f}_j| \to 0$), aralarındaki kenar ağırlığı o kadar büyüktür ($w(i,j) \to 1$).
- $\sigma$ parametresi, afinitenin parlaklık/renk değişimlerine karşı duyarlılığını kontrol eder.
6.2 Grafik Kesimi (Graph Cut) ve Minimum Kesim (Min-Cut)
- Kesim (Cut): Grafikteki tüm düğümleri ($V$) birbirine ayrık iki alt gruba ($V_A$ ve $V_B$) ayıran bölme hattıdır ($V_A \cup V_B = V, V_A \cap V_B = \emptyset$).
- Kesim Kümesi (Cut-Set): Bu bölme esnasında koparılan/kesilen tüm kenarların kümesidir.
- Kesim Maliyeti (Cost of Cut): Kesilen tüm kenarların ağırlıklarının toplamıdır:
$$\text{cut}(V_A, V_B) = \sum_{u \in V_A, , v \in V_B} w(u,v)$$
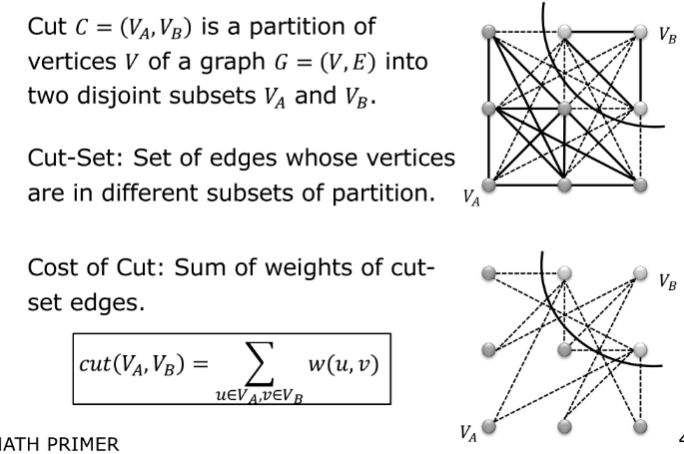
Min-Cut Algoritması ve Kritik Kusuru (Bias Toward Small Segments)
İlk akla gelen bölütleme yöntemi, kesim maliyetini minimize eden $\arg\min \text{cut}(V_A, V_B)$ hattını bulmaktır (Min-Cut). Çünkü aynı gruptaki piksellerin birbirine benzer (yüksek afinite), farklı gruptakilerin ise benzersiz (düşük afinite) olması istenir.
Min-Cut Kusuru (Küçük Parça Eğilimi): Min-Cut algoritması, grafiği sürekli çok küçük, tekil veya izole parçalara (örneğin sadece tek bir köşe pikseline) bölmeye karşı ölümcül bir eğilime (bias) sahiptir.
Nedeni: Kesim maliyeti kesilen kenar sayısıyla doğru orantılı olarak büyür. Çok zayıf 100 kenarı keserek büyük bir nesneyi ayırmanın maliyeti, tek bir güçlü kenarı (örneğin tek bir pikseli) kesmekten çok daha büyüktür. Bu yüzden Min-Cut, görüntünün kenarlarından sürekli minik pikseller kopararak anlamsız parçalar üretir.
6.3 Normalize Edilmiş Kesim (Normalized Cut - NCut)
Jianbo Shi ve Jitendra Malik (2000), bu küçük parça hatasını çözmek amacıyla kesim maliyetini elde edilen alt grafiklerin toplam boyutlarıyla oranlayarak normalize eden Normalized Cut (NCut) yöntemini geliştirmiştir.
1. Alt Grafik Boyutunun Ölçülmesi (Association)
Bir alt grafiğin ($V_A$) boyutu, onun tüm büyük grafikle ($V$) ne kadar güçlü bağlara sahip olduğu toplanarak ölçülür; buna Association (İlişkilendirme) denir:
$$\text{assoc}(V_A, V) = \sum_{u \in V_A, , v \in V} w(u,v)$$
2. NCut Formülasyonu
Bölüm sonucunda elde edilen $V_A$ ve $V_B$ alt grupları için normalize edilmiş kesim maliyeti şu şekilde tanımlanır:
$$\text{NCut}(V_A, V_B) = \frac{\text{cut}(V_A, V_B)}{\text{assoc}(V_A, V)} + \frac{\text{cut}(V_A, V_B)}{\text{assoc}(V_B, V)}$$
- Bu formülasyon sayesinde, eğer alt gruplardan biri çok küçük olursa (örneğin $V_A$ sadece tek bir piksel içerirse), paydadaki $\text{assoc}(V_A, V)$ değeri çok küçük olacağından terimin değeri patlar ve toplam $\text{NCut}$ maliyeti devasa düzeyde cezalandırılır.
- Algoritma ancak her iki alt grafik de dengeli ve büyük boyutlarda olduğunda minimum değeri üretir.
3. Çözüm Zorluğu ve Spektral Yaklaşımlar (Spectral Methods)
- NP-Complete Karmaşıklığı: $\text{NCut}$ değerini tam olarak minimum yapan ayrık kesimi bulmanın bilinen hiçbir polinom-zamanlı algoritması yoktur; problem NP-Complete sınıfındadır.
- Spektral Gevşetme (Shi-Malik Özvektör Çözümü): Shi ve Malik, bu zorlu ayrık optimizasyon problemini sürekli (continuous) bir düzleme gevşeterek (relaxation), genelleştirilmiş bir özdeğer/özvektör problemine dönüştürmüştür: $$(D - W)\mathbf{y} = \lambda D \mathbf{y}$$ Burada $W$ afinite matrisi, $D$ ise köşegen derece matrisidir ($D_{ii} = \sum_j W_{ij}$). İkinci en küçük özdeğere karşılık gelen özvektör (Fiedler vector), görüntüyü en optimal şekilde ikiye bölen sürekli göstergedir.
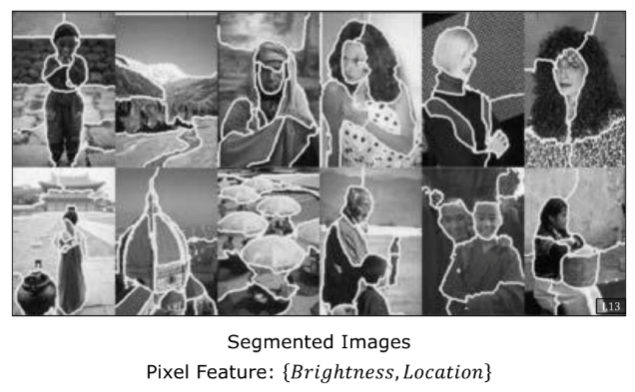
7. Özetleyici Teknik Karşılaştırma Matrisi
Aşağıdaki matris, bu derste incelenen tüm görüntü bölütleme yaklaşımlarının temel matematiksel karar mekanizmalarını, girdi gereksinimlerini, avantajlarını ve sınır koşullarını özetlemektedir:
| Algoritma Sınıfı | Temel Matematiksel Formül / Karar | Kullanıcı Parametre Girişi | En Güçlü Avantajı | Temel Sınırlaması / Çöküş Noktası |
|---|---|---|---|---|
| k-Means | $\text{Cluster}(x_j) = \arg\min_i |\mathbf{f}_j - m_i|$ | Küme sayısı $k$ | Basit matematik, hızlı hesaplama ve kolay paralelleştirme | $k$ değerinin önceden bilinmesi zorunluluğu, rastgele ilklendirme hassasiyeti ve aykırı değerlere (outliers) dayanıksızlık |
| Mean-Shift | $m_i \leftarrow \text{centroid}(W(m_i))$ (Hill-Climbing) | Pencere yarıçapı $W$ (Bandwidth) | $k$ değerini kendi keşfeder; keyfi küme şekillerine ve aykırı değerlere karşı son derece dayanıklıdır | Her piksel için bağımsız tepe tırmanma yapıldığından hesaplama maliyetinin çok yüksek olması; $W$’ya aşırı duyarlılık |
| Min-Cut (Graph) | $\min \sum_{u \in V_A, v \in V_B} w(u,v)$ | Yok (Saf min-cut) | Küresel grafik ilişkilerini kullanarak nesne sınırlarını matematiksel optimize etme | Grafikten sürekli tekil pikselleri koparma eğilimi (bias toward small isolated segments) |
| Normalized-Cut (NCut) | $\min \left( \frac{\text{cut}(V_A, V_B)}{\text{assoc}(V_A, V)} + \frac{\text{cut}(V_A, V_B)}{\text{assoc}(V_B, V)} \right)$ | Gevşetme parametreleri / Özvektör eşiği | NCut normalizasyonu sayesinde dengeli, anlamsal ve büyük nesne segmentleri üretimi | NP-Complete olması; sadece matris özvektör (spectral) yaklaşıklıklarıyla çözülebilmesi |