Çok Katmanlı Ağlar, Gradyan Azalma ve Geriye Yayılım (Multi-Layer Networks & Backpropagation)
- 1. Çok Katmanlı Yapay Sinir Ağları (Multi-Layer Perceptron - MLP)
- 2. Hata Fonksiyonu ve Gradyan Azalma (Gradient Descent)
- 3. Geriye Yayılım Algoritması (Backpropagation)
- 4. Örnek Uygulamalar (Example Applications)
- 5. Ne Zaman Makine Öğrenmesi Kullanmalıyız? (When to Use Machine Learning?)
Bu ders notu, yapay sinir ağları konusunun ikinci ve en kritik evresini; çok katmanlı ileri beslemeli ağ yapısını (Multi-Layer Perceptron - MLP), hata fonksiyonlarının çok boyutlu geometrisini, optimizasyon motoru olan Gradyan Azalmayı (Gradient Descent) ve yapay zeka devriminin matematiksel omurgasını oluşturan Geriye Yayılım Algoritmasını (Backpropagation) tüm doğrusal cebirsel ve diferansiyel zincir kuralı ispatlarıyla ele almaktadır.
1. Çok Katmanlı Yapay Sinir Ağları (Multi-Layer Perceptron - MLP)
Tek bir perceptron veya tek katmanlı doğrusal sınıflandırıcılar yalnızca düz bir hiperdüzlemle ayrılabilen (linearly separable) problemleri çözebilirken, araya birden çok Gizli Katman (Hidden Layer) eklenerek oluşturulan Çok Katmanlı Yapay Sinir Ağları (MLP), girdi ile çıktı arasında son derece karmaşık ve doğrusal olmayan her türlü manifold haritalama (mapping) işlevini öğrenebilir.
flowchart TD
    subgraph InputLayer["Girdi Katmanı (Layer 1)"]
        X1["x₁ (Piksel 1)"]
        X2["x₂ (Piksel 2)"]
        Xdots["..."]
        XN["x₇₈₄ (Piksel 784)"]
    end

    subgraph HiddenLayer["Gizli Katman (Layer 2)"]
        H1["Nöron 1 (σ)"]
        H2["Nöron 2 (σ)"]
        Hdots["..."]
        HM["Nöron 30 (σ)"]
    end

    subgraph OutputLayer["Çıktı Katmanı (Layer 3/L)"]
        O0["Sınıf 0"]
        O1["Sınıf 1"]
        Odots["..."]
        O9["Sınıf 9"]
    end

    InputLayer -->|"Ağırlıklar W^(2), Sapmalar b^(2)"| HiddenLayer
    HiddenLayer -->|"Ağırlıklar W^(3), Sapmalar b^(3)"| OutputLayer

    style InputLayer fill:#1a1a2e,stroke:#e94560,color:#fff
    style HiddenLayer fill:#16213e,stroke:#4cc9f0,color:#fff
    style OutputLayer fill:#0f3460,stroke:#e94560,color:#fff
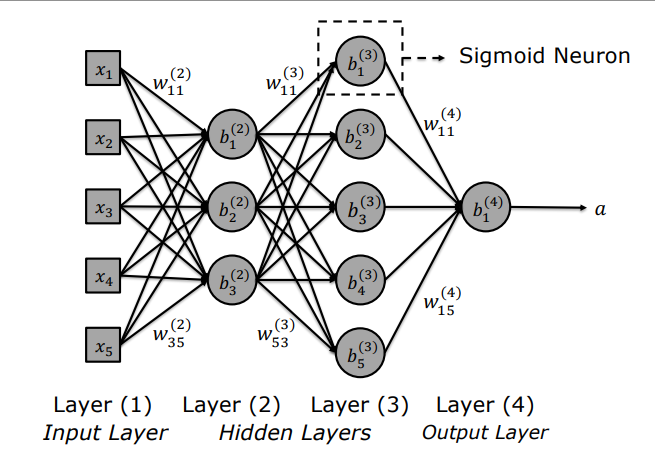
1.1 MLP Ağ Anatomisi ve Parametrik Gösterim
Tipik bir Çok Katmanlı Yapay Sinir Ağı üç ana katman hiyerarşisinden oluşur:
- Girdi Katmanı (Input Layer - Layer 1): Ağın dış dünyadan ham veriyi kabul ettiği ilk katmandır. Buradaki düğümler herhangi bir matematiksel aktivasyon veya dönüşüm hesaplamaz; yalnızca girdi vektörünü (örneğin MNIST görüntüsündeki $28 \times 28 = 784$ adet piksel parlaklık değerini) sonraki katmanlara dağıtır.
- Gizli Katmanlar (Hidden Layers - Layer $2 \dots L-1$): Girdi ile çıktı katmanı arasında yer alan içsel katmanlardır. Bu katmanlardaki sigmoid/ReLU nöronları, ham piksel girdilerinden kademeli olarak daha soyut ve üst düzey anlamsal özellikleri (kenarlar, dokular, köşe birleşimleri ve parça geometrileri) öğrenir.
- Çıktı Katmanı (Output Layer - Layer $L$): Nihai sınıflandırma veya regresyon kararının üretildiği son katmandır. Örneğin MNIST rakam tanıma ağında, her biri $0$’dan $9$’a kadar bir rakam sınıfını temsil eden tam 10 adet çıktı nöronu yer alır.
1.2 Michael Nielsen’in MNIST Karar Ağı Örneği
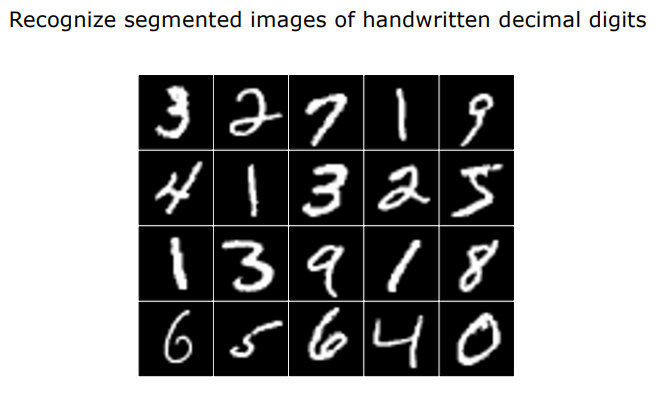
Bilgisayarlı görü literatüründe standart referans olarak kabul edilen Michael Nielsen’in MNIST el yazısı rakam sınıflandırma mimarisi şu katman yapısına sahiptir:
- Girdi Katmanı: 784 nöron ($28 \times 28$ piksel normalize edilmiş parlaklık dizisi).
- Gizli Katman: 30 nöron (tam bağlı / fully connected yapı).
- Çıktı Katmanı: 10 nöron (0’dan 9’a her bir sınıf için bir aktivasyon).
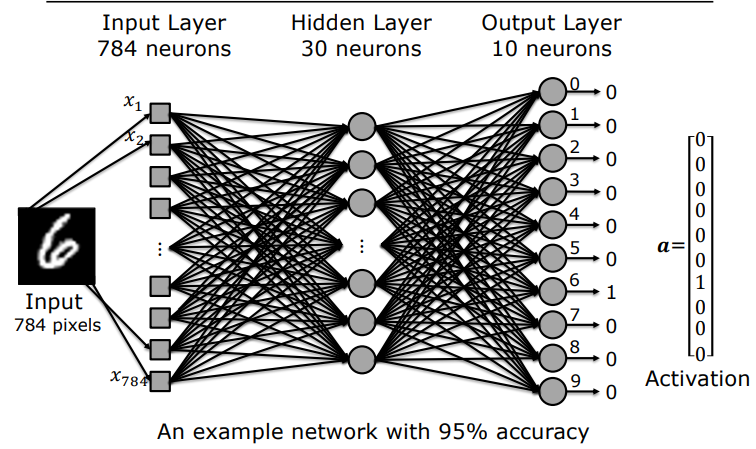
Parametre Sayısı Analizi:
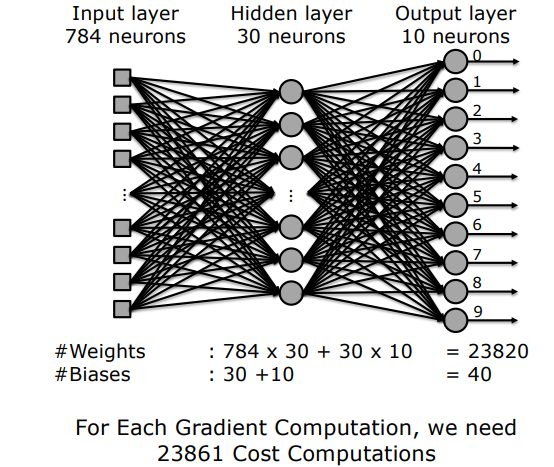
- Ağırlıklar (Weights):
-
- Katmandan 2. Katmana: $784 \times 30 = 23.520$ adet
-
- Katmandan 3. Katmana: $30 \times 10 = 300$ adet
- Toplam Ağırlık: $23.520 + 300 = 23.820$ adet
-
- Sapmalar (Biases):
- Gizli Katman Sapmaları: $30$ adet
- Çıktı Katmanı Sapmaları: $10$ adet
- Toplam Sapma: $30 + 10 = 40$ adet
- Toplam Eğitilebilir Parametre: $$\text{Toplam Parametre} = 23.820 + 40 = 23.860 \text{ adet}$$
2. Hata Fonksiyonu ve Gradyan Azalma (Gradient Descent)
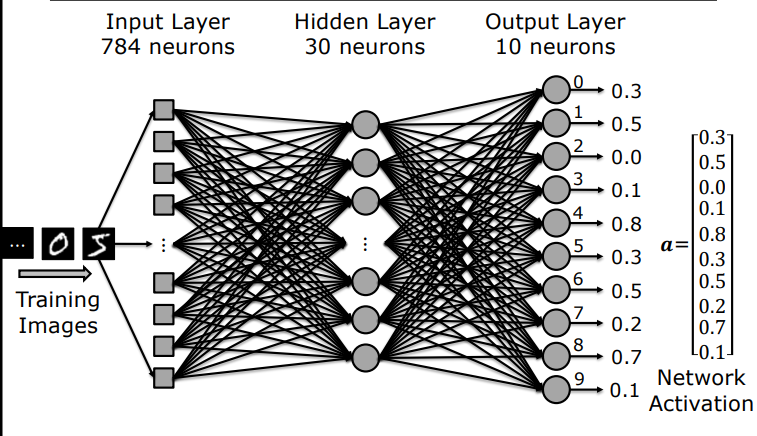
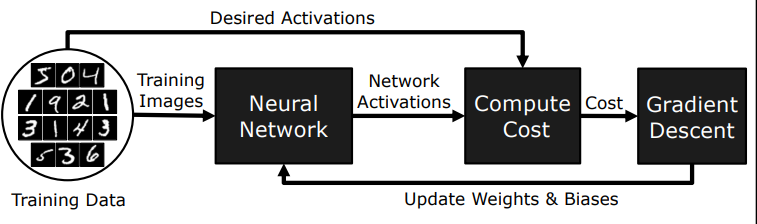
Rastgele başlatılan bir yapay sinir ağı, girdi olarak verilen bir “5” rakamı için hedef sınıfa değil, rastgele dağılmış hatalı aktivasyonlar üretecektir. Öğrenme süreci, bu hatayı ölçen maliyet fonksiyonunu adım adım minimize eden bir parametre optimizasyonudur.
2.1 Hedef Aktivasyonlar ve Maliyet Fonksiyonu (Cost Function)
Eğitim setindeki her $x$ görüntüsü için bir gerçek hedef sınıf etiketi (ground truth label) bulunur. Bu etiketler One-Hot Encoding formatında $\hat{\mathbf{a}}(x)$ vektörü olarak ifade edilir:
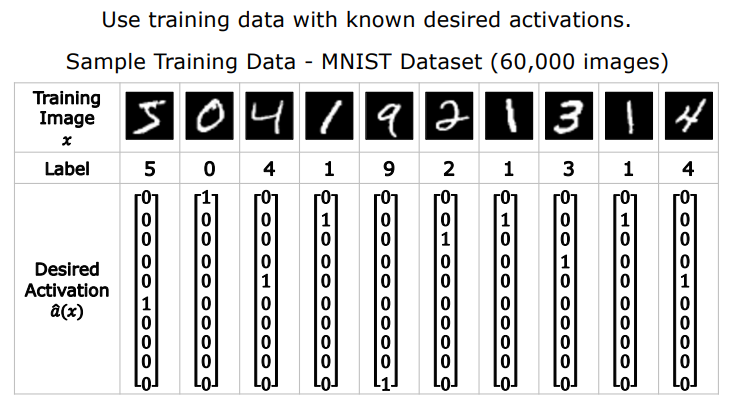
Eğitilmemiş ağ rastgele ağırlıklarla çalıştırıldığında çıktılar hedeften tamamen sapmış durumdadır:
Karesel Hata (MSE) Maliyet Fonksiyonu:
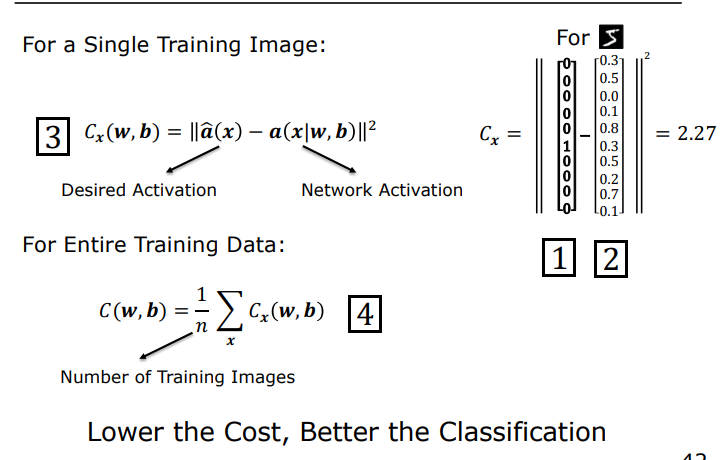
Tek bir $x$ eğitim örneği için karesel maliyet $C_x$, ağın çıktı aktivasyon vektörü $\mathbf{a}(x)$ ile hedef vektör $\hat{\mathbf{a}}(x)$ arasındaki Öklid mesafesinin karesidir:
$$C_x(\mathbf{w}, \mathbf{b}) = |\hat{\mathbf{a}}(x) - \mathbf{a}(x | \mathbf{w}, \mathbf{b})|^2 = \sum_{j} \left( \hat{a}_j(x) - a_j^L(x) \right)^2$$
Tüm eğitim kümesi ($n = 60.000$ görüntü) üzerindeki genel ortalama maliyet $C(\mathbf{w}, \mathbf{b})$ ise:
$$C(\mathbf{w}, \mathbf{b}) = \frac{1}{n} \sum_{x} C_x(\mathbf{w}, \mathbf{b})$$
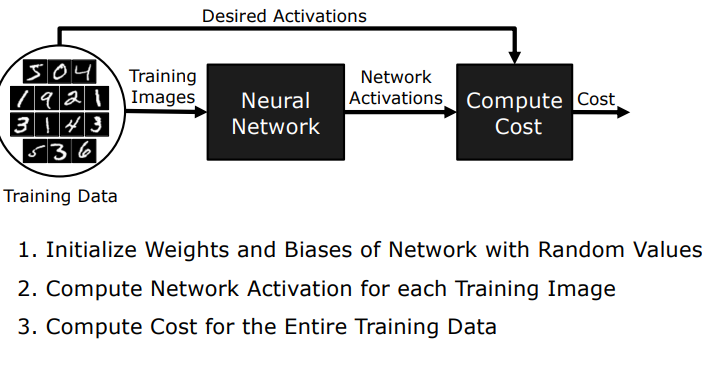
flowchart LR
    Init["1. Ağırlık ve Sapmaları\nRastgele Değerlerle Başlat"] --> Forward["2. Her Eğitim Görüntüsü İçin\nİleri Besleme Aktivasyonlarını Hesapla"]
    Forward --> Cost["3. Tüm Veri Seti İçin\nOrtalama Maliyeti C(w,b) Hesapla"]
    Cost --> Opt["4. Optimizasyon (Gradient Descent)\nile Parametreleri Güncelle"]
    Opt --> Forward

    style Init fill:#1a1a2e,stroke:#e94560,color:#fff
    style Forward fill:#16213e,stroke:#4cc9f0,color:#fff
    style Cost fill:#0f3460,stroke:#e94560,color:#fff
    style Opt fill:#53354a,stroke:#e94560,color:#fff
2.2 Gradyan Azalma (Gradient Descent) Matematiği ve Hata Yüzeyi
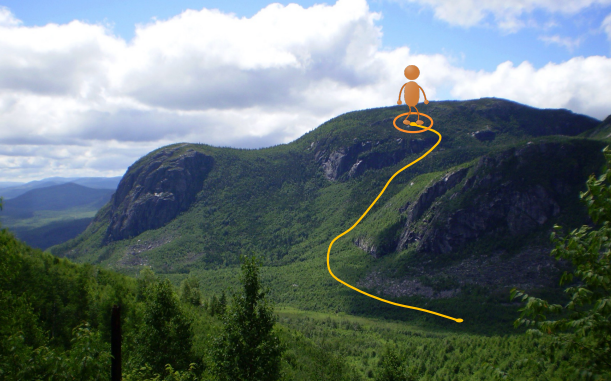
Amacımız, 23.860 boyutlu parametre uzayında tanımlı $C(\mathbf{w}, \mathbf{b})$ fonksiyonunun dip noktasını (minimum maliyeti) bulmaktır.
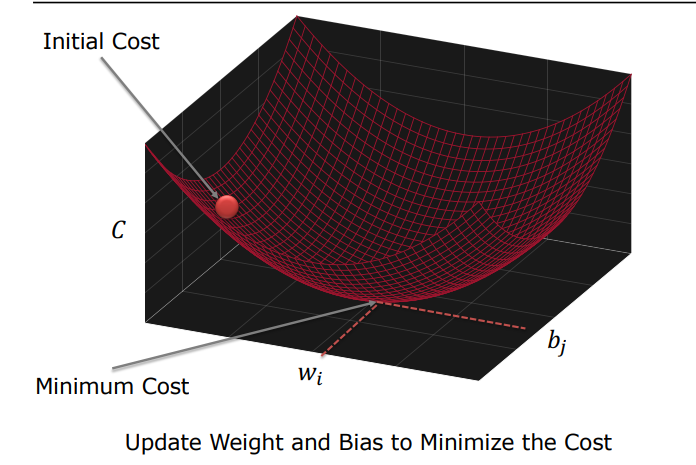
Analitik İniş İspatı:
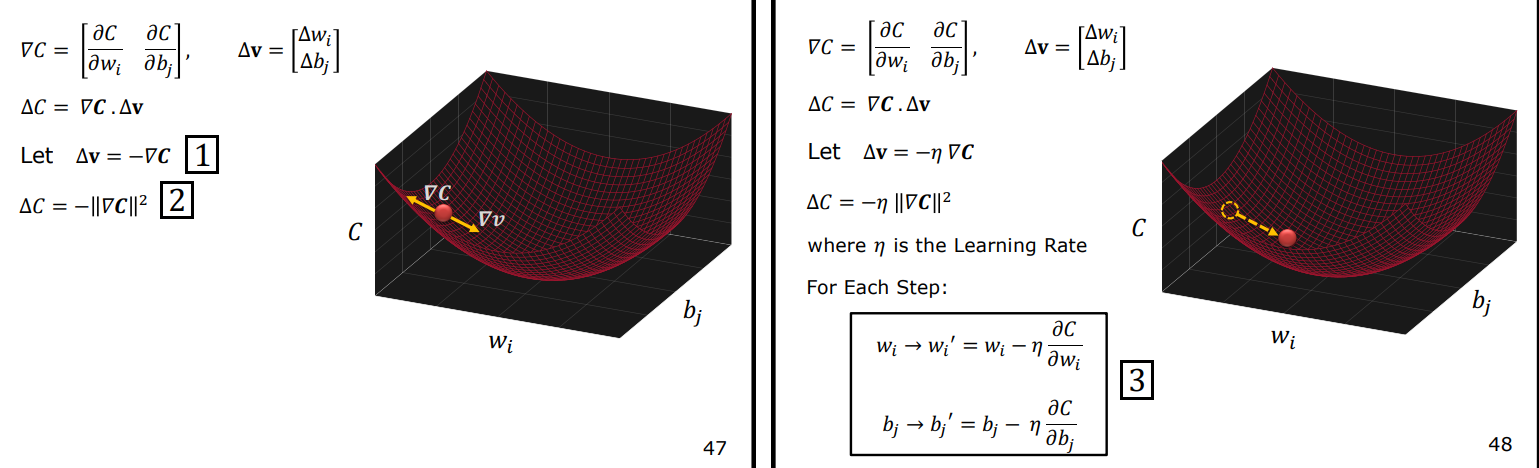
Parametrelerdeki küçük bir $\Delta \mathbf{v} = [\Delta w_1, \dots, \Delta b_1, \dots]^T$ değişiminin maliyette yarattığı $\Delta C$ farkı, çok değişkenli Taylor açılımıyla şu iç çarpıma eşittir:
$$\Delta C \approx \nabla C \cdot \Delta \mathbf{v}$$
Burada $\nabla C$, maliyetin tüm parametrelere göre kısmi türevler vektörüdür (Gradyan):
$$\nabla C = \left[ \frac{\partial C}{\partial w_1}, \frac{\partial C}{\partial w_2}, \dots, \frac{\partial C}{\partial b_1}, \dots \right]^T$$
Maliyette maksimum düşüşü ($\Delta C < 0$) sağlamak için Cauchy-Schwarz eşitsizliği gereğince $\Delta \mathbf{v}$ vektörü gradyanın tam zıt yönünde seçilmelidir:
$$\Delta \mathbf{v} = -\eta \nabla C$$
Burada $\eta > 0$ Öğrenme Oranıdır (Learning Rate). Bu seçim yapıldığında:
$$\Delta C \approx \nabla C \cdot (-\eta \nabla C) = -\eta |\nabla C|^2 \leq 0$$
Maliyet değişimi kesinlikle negatif olur; yani her adımda maliyet daima azalır!
Parametre Güncelleme Formülleri:
$$w_i \leftarrow w_i - \eta \frac{\partial C}{\partial w_i}$$ $$b_j \leftarrow b_j - \eta \frac{\partial C}{\partial b_j}$$
2.3 Geleneksel Sonlu Farklar (Brute-Force) Yönteminin Çöküşü
Gradyan azalmayı uygulayabilmek için her iterasyonda $23.860$ adet kısmi türevi hesaplamamız gerekir.
Geleneksel Sonlu Farklar (Finite Differences) numerik türevi kullanılırsa:
$$\frac{\partial C}{\partial w_k} \approx \frac{C(\mathbf{w} + \epsilon \mathbf{e}_k, \mathbf{b}) - C(\mathbf{w}, \mathbf{b})}{\epsilon}$$
Hesaplama Yükü Analizi:
- Tek bir görüntü için ileri besleme: $23.820$ çarpma.
- Tüm veri seti ($60.000$ görüntü) için tek bir $C(\mathbf{w}, \mathbf{b})$ hesabı: $$60.000 \times 23.820 \approx 1.43 \times 10^9 \text{ çarpım}$$
- $23.860$ parametrenin tamamı için sonlu farklar çalıştırmak, eğitim setini 23.861 kez baştan geçirmeyi gerektirir: $$\text{Tek Bir Gradient Adımının Yükü} = 23.861 \times (1.43 \times 10^9) \approx \mathbf{3.4 \times 10^{13}} \text{ çarpma!}$$
Kritik Sonuç: Saniyede milyarlarca işlem yapan süper bilgisayarlarda bile tek bir optimizasyon adımı günler sürer. Brute-force sonlu farklar yaklaşımı pratik olarak tamamen imkansızdır.
3. Geriye Yayılım Algoritması (Backpropagation)
Yapay zeka devrimini başlatan en büyük matematiksel buluş, gradyan hesaplama yükünü $10.000$ kat düşüren Geriye Yayılım (Backpropagation) algoritmasıdır.
3.1 Zincir Kuralı (Chain Rule) ile Analitik Çıkarım
Geriye yayılım, kalkülüste yer alan diferansiyel zincir kuralına dayanır. Çıktı katmanındaki ($L = 4$) $w_{11}^{(4)}$ ağırlığına göre maliyetin türevini adım adım çözelim:
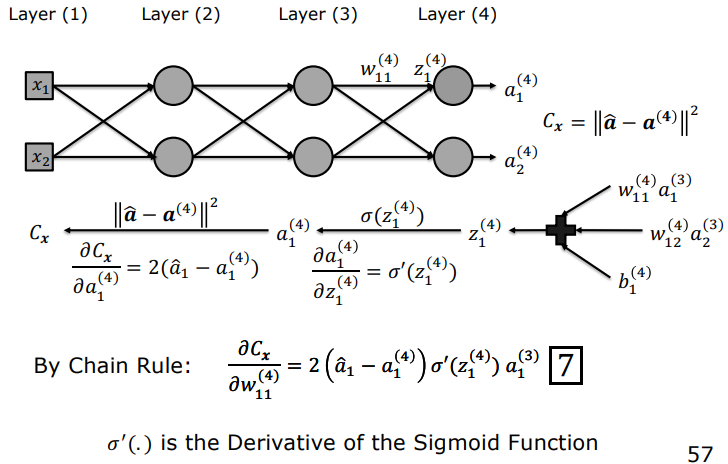
Zincir kuralı bağıntısı:
$$\frac{\partial C_x}{\partial w_{ji}^L} = \frac{\partial C_x}{\partial a_j^L} \cdot \frac{\partial a_j^L}{\partial z_j^L} \cdot \frac{\partial z_j^L}{\partial w_{ji}^L}$$
Bu üç diferansiyel terimi tek tek analitik olarak hesaplayalım:
- Maliyetin Aktivasyona Göre Türevi: $$C_x = \sum_k (a_k^L - \hat{a}_k)^2 \implies \frac{\partial C_x}{\partial a_j^L} = 2(a_j^L - \hat{a}_j)$$
- Aktivasyonun Net Girdiye Göre Türevi (Sigmoid Türevi): $$a_j^L = \sigma(z_j^L) \implies \frac{\partial a_j^L}{\partial z_j^L} = \sigma’(z_j^L) = \sigma(z_j^L)(1 - \sigma(z_j^L)) = a_j^L (1 - a_j^L)$$
- Net Girdinin Ağırlığa Göre Türevi: $$z_j^L = \sum_k w_{jk}^L a_k^{L-1} + b_j^L \implies \frac{\partial z_j^L}{\partial w_{ji}^L} = a_i^{L-1}$$
Üç terimi çarptığımızda:
$$\frac{\partial C_x}{\partial w_{ji}^L} = \underbrace{\left[ 2(a_j^L - \hat{a}j) \cdot a_j^L (1 - a_j^L) \right]}{\text{Yerel Gradyan } \delta_j^L} \cdot a_i^{L-1}$$
3.2 Yerel Gradyan ($\delta$) ve Hataların Geriye Yayılması
Köşeli parantez içindeki ifadeye $j$. nöronun Yerel Gradyanı (Local Gradient - $\delta_j^L$) denir:
$$\delta_j^L = \frac{\partial C_x}{\partial z_j^L} = 2(a_j^L - \hat{a}_j) \cdot a_j^L (1 - a_j^L)$$
Böylece tüm ağırlık ve sapma türevleri son derece kompakt iki çarpıma indirgenir:
$$\frac{\partial C_x}{\partial w_{jk}^{(l)}} = \delta_j^{(l)} a_k^{(l-1)}$$ $$\frac{\partial C_x}{\partial b_j^{(l)}} = \delta_j^{(l)}$$
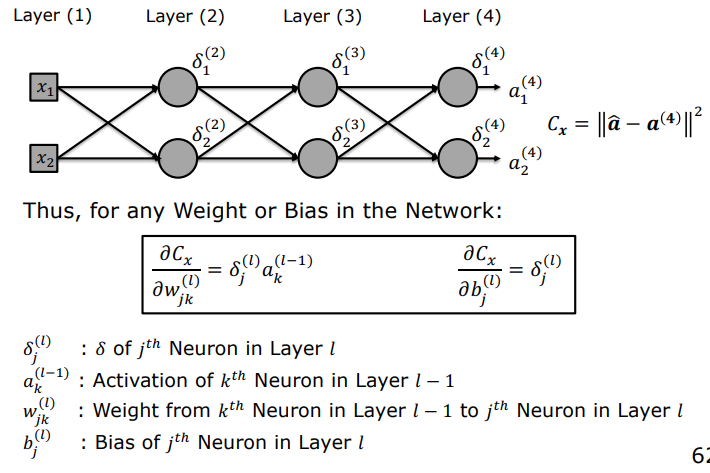
Gizli Katman Yerel Gradyanlarının Geriye Doğru Hesabı:
Çıktı katmanındaki $\delta^L$ bilindiğinde, bir önceki gizli katmanın yerel gradyanı $\delta^l$, bir sonraki katmanın deltaları ve aradaki ağırlıklar kullanılarak geriye doğru akar:
$$\delta_j^l = \left( \sum_k \delta_k^{l+1} w_{kj}^{l+1} \right) a_j^l (1 - a_j^l)$$
flowchart RL
    subgraph BackpropFlow["Hata ve Gradyan Akışı (Geriye Doğru)"]
        DL["Çıktı Deltaları: δ^(L)"] -->|"W^(L)^T çarpımı"| DL1["Gizli Katman Deltaları: δ^(L-1)"]
        DL1 -->|"W^(L-1)^T çarpımı"| DL2["Önceki Katman Deltaları: δ^(2)"]
    end

    style DL fill:#e94560,stroke:#fff,color:#fff
    style DL1 fill:#0f3460,stroke:#4cc9f0,color:#fff
    style DL2 fill:#16213e,stroke:#4cc9f0,color:#fff
3.3 Hesaplama Karmaşıklığı Karşılaştırması
Backpropagation algoritmasının sağladığı devrimsel hesaplama kazancı:
| Yöntem | Görüntü Başına İşlem | Tüm Veri Seti (60.000 İmaj) İçin İterasyon Maliyeti | Göreceli Hız Kazancı |
|---|---|---|---|
| Sonlu Farklar (Finite Differences) | $23.861 \times 23.820 \approx 5.68 \times 10^8$ | $\mathbf{3.4 \times 10^{13}} \text{ işlem}$ | $1\times$ (Referans - Aşırı Yavaş) |
| Geriye Yayılım (Backpropagation) | $23.820 \text{ (İleri)} + 24.210 \text{ (Geri)} = 48.030$ | $\mathbf{2.8 \times 10^9} \text{ işlem}$ | $\mathbf{\approx 10.000\times \text{ Daha Hızlı!}}$ |
Devrimsel Sonuç: Backpropagation sayesinde gradyan hesaplama yükü tam $10^4$ kat azalarak saatler süren işlemler saniyelere indirilmiştir.
4. Örnek Uygulamalar (Example Applications)
Yapay sinir ağları, bilgisayarlı görüde piksel düzeyinden anlamsal sahne düzeyine kadar pek çok alanda kullanılmaktadır:
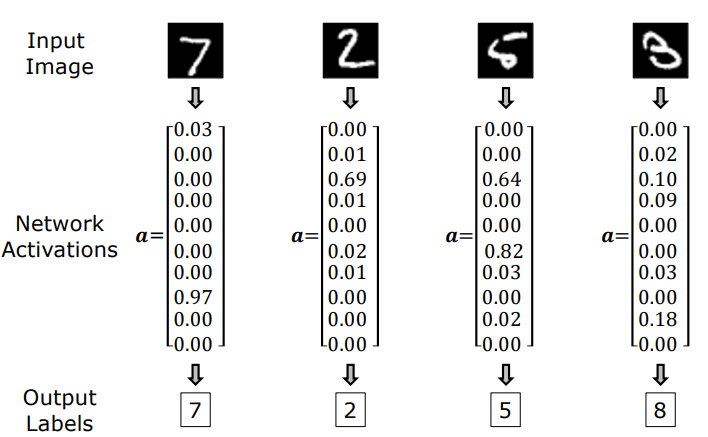
4.1 MNIST Karakter Tanıma Başarısı
Eğitilmiş 30 gizli nöronlu MLP ağı; eğik, deforme veya alışılmadık el yazısı rakamlarını yüksek güvenle tanır:
4.2 Yann LeCun’un Evrişimli Sinir Ağları (CNN / LeNet)
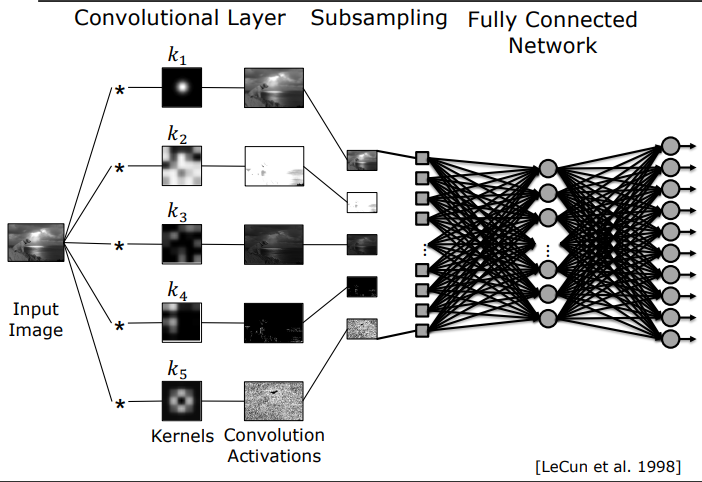
Klasik bilgisayarlı görüde Sobel, Gaussian veya Gabor gibi filtreler uzmanlar tarafından el ile tasarlanırdı. Yann LeCun (1998) tarafından geliştirilen Evrişimli Sinir Ağlarında (CNN):
- Evrişim çekirdeklerinin ($k_1 \dots k_5$) katsayıları doğrudan ağın öğrenilebilir ağırlıkları olarak atanır.
- Geriye yayılım algoritması, bu filtreleri hedef göreve göre otomatik olarak optimize eder.
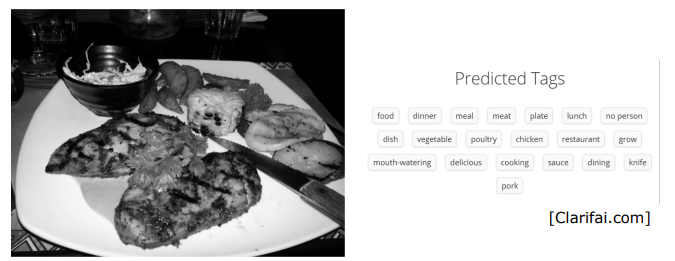
4.3 Görsel Anlamsal Etiketleme (Clarifai)
Derin ağlar, karmaşık görüntülerden tek bir sınıf yerine onlarca anlamsal kavramı aynı anda çıkarabilir:
5. Ne Zaman Makine Öğrenmesi Kullanmalıyız? (When to Use Machine Learning?)
Derin öğrenmenin popülaritesi her mühendislik problemini doğrudan makine öğrenmesiyle çözme dürtüsü oluştursa da, fiziksel ve optik prensiplerle çözülebilecek problemler için ML kullanmak ciddi verimsizliklere yol açar.
5.1 Birinci İlkeler (First Principles) vs. Veri Tabanlı Yaklaşım (ML Approach)
Serbest düşen bir nesnenin aldığı yolu hesaplama problemini düşünelim:
- Fiziksel Birinci İlkeler (Newton): $$s = ut + \frac{1}{2}at^2$$ Formül kesindir, anında hesaplanır, sıfır veri gerektirir ve yerçekimi ivmesi ($a$) hakkında derin fiziksel içgörü sunar.
- Veri Tabanlı Yaklaşım (ML): Farklı yüksekliklerden yüzlerce top bırakıp kronometreyle düşüş sürelerini ölçerek devasa bir veri kümesi toplamak ve bunu bir yapay sinir ağına uydurmak gerekir.
ML Yaklaşımının Bu Senaryodaki Sınırları:
- Zaman ve İşlem İsrafı: Bilinen bir analitik formülü öğrenmek için devasa veri toplama ve GPU gücü harcanır.
- Sıfır İçgörü (Black-Box): Ağ girdi ile çıktı arasında başarılı bir eşleme yapsa dahi, fizik yasaları ve yerçekimi ivmesi hakkında hiçbir açıklanabilir bilgi sunamaz.
- Son Mil Sınırı (The Last Mile Problem): Veri tabanlı modeller hızlıca %90-95 başarıya ulaşır; ancak güvenlik kritik sistemlerin gerektirdiği %99.99’luk kusursuzluğa ulaşmak için veri toplamak ve parametre bükmek aşırı derecede verimsiz bir sürece dönüşür.
5.2 Karar Matrisi: Birinci İlkeler mi, Makine Öğrenmesi mi?
| Karar Kriteri | Birinci İlkeler (First Principles) | Makine Öğrenmesi (Machine Learning) |
|---|---|---|
| Sürecin Bilinirliği | Fiziksel ve optik yasalar (perspektif projeksiyon, Lambertian yansıma, kalibrasyon) net olarak bilinmektedir. | Süreç analitik modellenemeyecek kadar karmaşık, kaotik ve varyasyonludur (el yazısı, doğal yüzler). |
| Açıklanabilirlik | Kararların arkasındaki matematiksel eşitlikler ve fiziksel parametreler tamamen şeffaftır. | Sistem bir kara kutudur (black-box); milyonlarca ağırlığın içsel semantiği doğrudan açıklanamaz. |
| Veri Gereksinimi | Eğitim verisine ihtiyaç duymaz; fiziksel formülasyon anında uygulanır. | Genelleme için binlerce/milyonlarca etiketli eğitim verisine ve temizlemeye ihtiyaç duyar. |
| İşlem & Donanım Maliyeti | Düşük işlem gücüyle standart CPU’larda anında çalışır. | Yüksek GPU/TPU donanım yatırımı ve günlerce süren eğitim iterasyonları gerektirir. |
Altın Kural (Simbiyotik İlişki): Bilgisayarlı görüde en üstün yaklaşım, problemi analitik olarak çözülebildiği yere kadar birinci ilkelerle sadeleştirmek; deterministik modellerin tükendiği o karmaşık ve gürültülü manifold sınırlarında kontrolü makine öğrenmesi algoritmalarına devretmektir.